Exploración de datos: del problema a la evidencia
En el tercer encuentro del Semillero ANIF 2026-II, Óscar W. Orozco presentó el recorrido que va de la pregunta de investigación a la evidencia, pasando por las fuentes, la calidad, la exploración y la visualización de los datos.
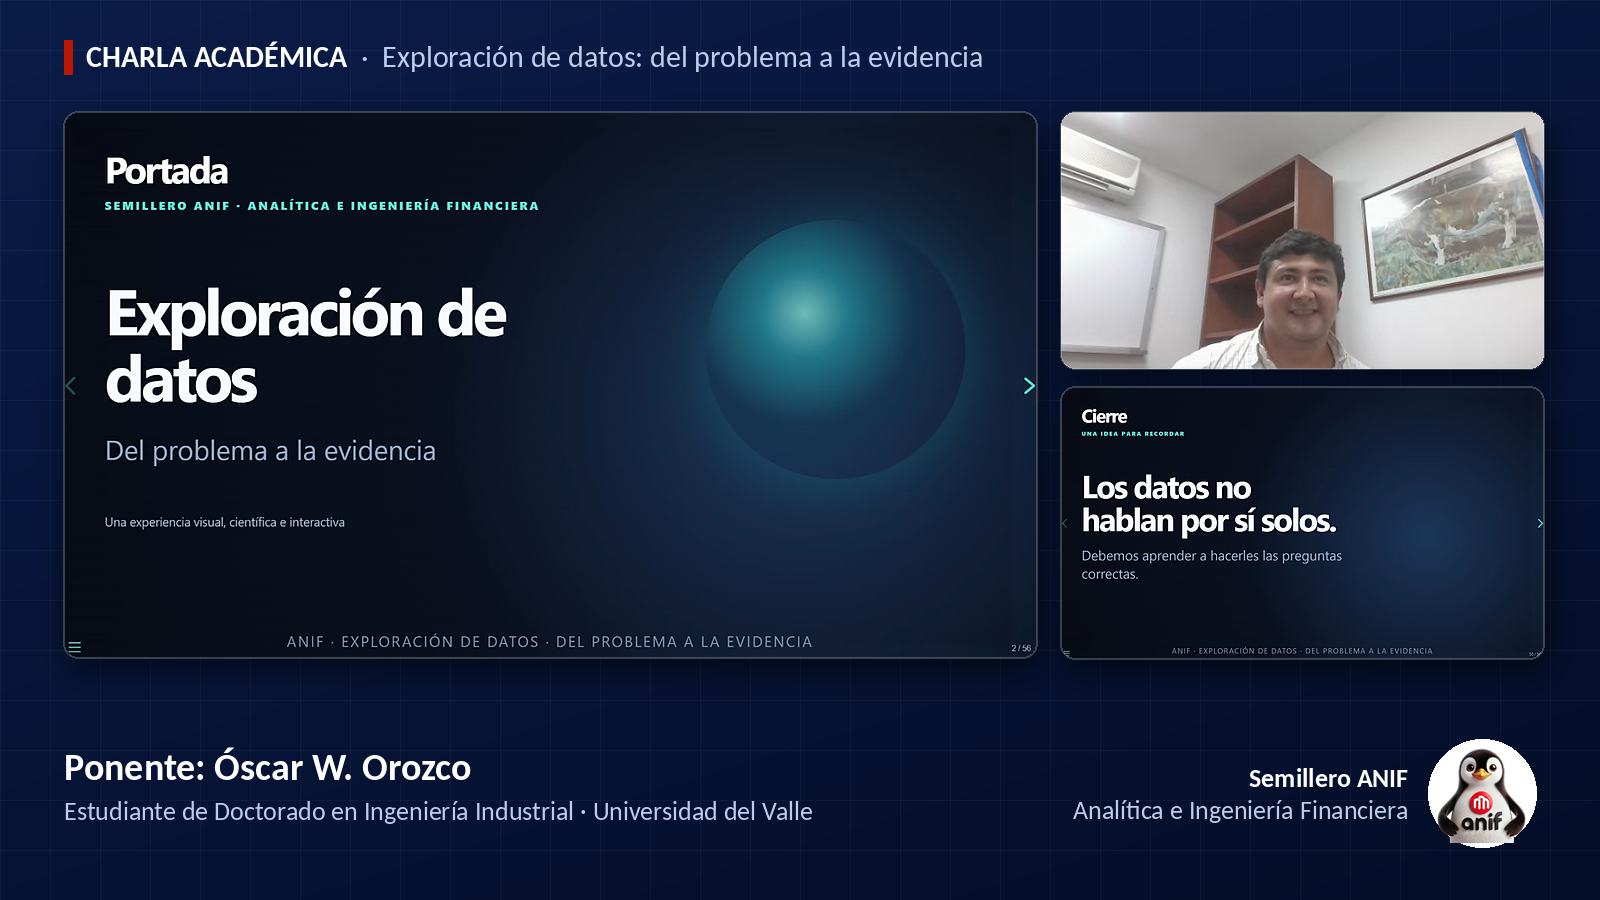
El 22 de octubre, el Semillero de Investigación en Analítica e Ingeniería Financiera (ANIF) realizó la charla académica “Exploración de datos: del problema a la evidencia”, a cargo de Óscar W. Orozco, estudiante de Doctorado en Ingeniería con énfasis en Ingeniería Industrial de la Universidad del Valle.
Óscar es estadístico y magíster en Economía Aplicada de la Universidad del Valle, especialista en Actuaría y Finanzas de la Universidad Nacional de Colombia, y cuenta con cerca de diez años de experiencia en análisis de datos en los sectores de energía, riesgos, seguros, finanzas y consultoría.
Esta charla dio continuidad a la sesión anterior, en la que se trabajó cómo pasar de una idea a un problema de investigación. Ahora la pregunta fue: una vez definido el problema, ¿cómo le damos respuesta con datos?
Los datos por sí solos no son evidencia
Hoy se generan millones de registros cada día, pero esa información no sirve para decidir hasta que se transforma, se organiza y se depura. A partir de un ejemplo de su trabajo de maestría, sobre la relación entre el ingreso per cápita y las tasas de mortalidad en el Reino Unido, Óscar mostró cómo una pregunta de investigación define qué datos se necesitan, de dónde obtenerlos y cómo estructurarlos.
El recorrido: de la pregunta a la evidencia
- Población y muestra: garantizar que la muestra analizada sea representativa.
- Fuentes de datos: encuestas, sensores, registros, APIs y bases abiertas, en formatos como CSV, Excel, JSON o bases de datos. Lo importante es que la fuente sea confiable.
- Estructura de los datos: transversales, series de tiempo o datos panel. De la estructura depende qué modelos se pueden aplicar.
- Tipos de variables: categóricas (nominales u ordinales), numéricas y de fecha. Identificarlas bien evita proponer modelos inadecuados.
- Calidad del dato: datos faltantes, duplicados, inconsistencias y valores atípicos. ¿Imputar, eliminar, corregir o cambiar de fuente? No hay receta: la decisión depende del propósito de la investigación.
- Exploración y descripción: el promedio es sensible a valores extremos. Por eso conviene complementarlo con la mediana, los cuartiles, la asimetría y la curtosis, además de analizar correlaciones, tendencias y patrones.
- Visualización: el gráfico debe “hablar solo” y pensarse para su público, dejando claro qué dice y qué no dice.
- Sesgos y robustez: correlación no implica causalidad, y es clave probar la sensibilidad de los resultados ante cambios en la muestra.
Óscar cerró con un recorrido por herramientas como Python, R, Pandas, Polars, KNIME, Power BI, Tableau, Plotly, Quarto, Jupyter y Streamlit, e insistió en la reproducibilidad, la transparencia y la ética en el manejo de los datos.
Espacio de preguntas
Los estudiantes preguntaron cómo acceder a datos de empresas privadas cuando la información pública no es suficiente. Óscar explicó que suelen compartirse bajo acuerdos de confidencialidad y que el acceso depende en gran medida de la gestión con el área que administra los datos: es difícil, pero no imposible. También se abrió la discusión sobre la importancia de aprender estas herramientas en la era de la inteligencia artificial.
💬 Desde el Semillero ANIF
Agradecemos a Óscar por una charla clara, completa e interactiva, que brindó a los integrantes una hoja de ruta para trabajar con los datos de sus propios proyectos de investigación.
📌 “Los datos no hablan por sí solos. Debemos aprender a hacerles las preguntas correctas.”